Sätteriプラグイン開発 #1 OGPカード表示
はじめに
前回の記事で,Sätteriのアーキテクチャとremark/rehypeとの違いを解説しました。その実践編として,今後何回かに分けて,実際にブログを育てていく過程で(バイブコーディングで)作成したSätteriプラグインを1本ずつ紹介していこうと思います。
最初に作ったのは,本文中に単独で貼った外部リンクをカード形式に変換するmdastPluginでした。
やりたいこと
折角の自分の城だし,なるべくUIはリッチにしたいということで,リンクをOGPカード形式で表示する機能を実装することにしました。やっぱただのハイパーテキストじゃ味気ないですからね。
一方で,脚注や参考ブロックに貼るリンク一覧までカード形式にしてしまうとそれはそれでごちゃごちゃした見た目になると思ったので,そこはハイパーテキストのままにしたい,みたいな感じで要件をClaudeに伝えた結果,一旦段落の構造で自動判定するという方式に落ち着きました。ざっくり言うと,「リンクだけの段落はカード形式で表示する」という仕様ですね。
ちなみに,OGPについてふんわりとしか理解していなかったんですが,あくまでサイトのメタ情報の書き方のお作法を定めたものであって,それを元にUIとして外部リンクをどう表示するかは各自で考えろって感じなんですね。
とはいえ人気の(?)機能なので,remark/rehypeであればremark-link-cardなどのプラグインが既に作られているのですが,Sätteri版に関しては,remark/rehypeのプラグインを移植するコミュニティプロジェクト(satteri-plugins等)を探しても該当のものは見当たりませんでした。SätteriのプラグインAPIはremark/rehypeと互換性が無く,既存プラグインのコードをそのまま移植することもできないので,「無いものは作るしかない」という感じですね。
全体設計
段落構造を判定するプラグインを1つ書けばOGPカードが表示されるわけではありません。実際にはリンクカード機能は,次の3つの部品で構成されています。
linkCardPlugin(mdastPlugin): ビルド時,対象段落をカードのHTMLに置き換える。キャッシュに無いURLはOGPメタデータをfetchし,結果をキャッシュに書き込む。取得に失敗しても例外は投げず,ドメイン名だけのフォールバックカードを描画する- JSONキャッシュ: 取得済みOGPメタデータの保存先。一度fetchしたURLは,次回以降のビルドではこのキャッシュを読むだけで済む
astro.config.mjsへの登録: プラグインをSätteriのプロセッサに渡して初めて有効になる
キャッシュを挟んでいるのは,SSG(Static Site Generation)がデプロイの度に全記事を再ビルドする仕様だからです。過去記事のリンクまで毎回fetchし直していたら記事が増えるほどビルド時間が伸びていってしまうので,このような設計にしています。
以降ではまず①の判定ロジックにどのプラグイン種別を使うかを検討し,それから各部品の実装を見ていきます。
Sätteriプラグインの種類
前回のおさらいですが,Sätteriは「パース・AST保持・変換・レンダリングまでをRustが担当し,プラグインだけをJS/TypeScriptで書く」という役割分担になっていて,そのプラグインには大きく2種類あるのでした。
mdastPlugin: mdast(Markdown AST)のノードを対象にするプラグイン。段落・見出し・数式ノードなど,Markdown構文レベルの要素ごとにコールバック(ビジター)を登録するhastPlugin: hast(HTML AST)のノードを対象にするプラグイン。パース後にHTML要素へ変換された後の<a>や<h2>などにコールバックを登録する
それぞれdefineMdastPlugin/defineHastPluginという関数を使って定義します。これらは型推論を効かせながらプラグインを定義するためのヘルパー関数です。
defineMdastPluginには,mdastのノード種別ごとにキーを立てたオブジェクトを渡します。同じ形のコールバックを複数のノード種別に対して同時に登録できます。
import { defineMdastPlugin } from "satteri";

const samplePlugin = defineMdastPlugin({
  name: "sample",
  paragraph(node, ctx) {
    // 段落ノードを見て判定・変換する
  },
  heading(node, ctx) {
    // 見出しノードを見て判定・変換する
  },
  link(node, ctx) {
    // リンクノードを見て判定・変換する
  },
  ...
});defineHastPluginも書き方はほぼ同じですが,elementキーだけ形が違います。
import { defineHastPlugin } from "satteri";

const sampleHastPlugin = defineHastPlugin({
  name: "sample-hast",
  element: {
    filter: ["a", "h2"], // このタグ名だけがRust側のフィルタを通ってvisitに渡ってくる
    visit(node, ctx) {
      // aタグ・h2タグのHTML要素を見て変換する
    },
  },
  text(node, ctx) {
    // テキストノードはelementと違い直接関数のまま
  },
  ...
});elementだけは直接の関数ではなく{ filter, visit }という形になっていて,filterに挙げたタグ名に一致する要素だけがRust側のフィルタを通ってJS側のvisitに渡ってきます。text・comment等はelementと違い直接関数のままです。
なお,Rust側のビジターがASTの走査を主導し,登録したノード種別のコールバックだけをJS側から呼び戻す仕組みについては,前回記事の「remark/rehypeとの違い」節をご参照ください。
さて,上で述べた通り,今回のリンクカード化で採用したのはmdastPluginの方だったわけですが,その選定理由について次節で見ていきます。
mdast vs hast
ある段落が「単体リンクだけの段落か?」を判定するためには,「段落の子要素がリンク1つだけか」「その段落の親がrootかどうか」という情報が必要ですが,この判定ロジックを書くだけならmdastPluginでもhastPluginでも特に変わりはありません。
判断が分かれるのは,「どちらの層で判定する方が,Sätteriの実装都合に振り回されずに済むか」という点です。脚注定義の例で見てみましょう。
[^1]: [参考記事](https://example.com)mdast(markdownToMdastで確認)は次の通りで,段落の子要素はlinkひとつだけです。
footnoteDefinition
└ paragraph { children: [link] }hast(markdownToHtmlで確認)は次の通りです。Sätteriが脚注の戻りリンク(↩)を自動で追加するため,<p>の子要素は2つになります。
<li>
  <p><a href="...">参考記事</a> <a href="#...">↩</a></p>
</li>同じ入力なのに,mdastとhastで段落の子要素数が変わっています。この戻りリンクはMarkdownの構文(footnoteDefinitionの中身)にはどこにも書かれておらず,mdast→hast変換の過程でSätteriが独自に足しているHTML構造です。
つまりhastの木には,元のMarkdown構文をそのまま反映した部分(段落・リンク)と,Sätteriのレンダリング判断で後から足された部分(戻りリンク,タイトなリストで省略される<p>など)が,区別なく同じ木の中に混在しています。今回のケースに関係ある「親がrootかどうか」という判定自体はこの戻りリンクの有無に影響されず動きますが,hastPluginを書く側は「この構造はMarkdownの構文由来か,Sätteriが足したものか」を都度見極めながら判定条件を組む必要があり,見極めを誤るとSätteriのレンダリング実装にたまたま依存した判定になってしまいます。
一方mdastの木には,このようなレンダリング由来の構造は一切現れません。パースされたMarkdown構文をそのまま映した,最小限の構造だけがあります。今回の判定条件(段落・リンク・親子関係)は,そもそも「Markdownとしてどう書かれているか」という話であって「HTMLとしてどう描画されるか」という話ではありません。Sätteriのレンダリング実装が変わっても影響を受けないmdastの層で判定する方が安全,というのが,mdastPluginを選んだ理由です。
実装
カード化対象の判定
それでは実装に入りましょう。前節で述べた通り,今回のプラグインで処理すべきparagraphの判定条件は2つです。
- 段落の子要素が1つだけで,それが
linkノードであること(且つlinkの中身がHTTP(S)のURLであること) - その段落の直接の親がmdastの
rootノードであること
具体的な例で見てみます。
https://example.com→ paragraph { children: [link] },親はroot。
条件1・条件2をどちらも満たすので,カード化の対象になる
詳しくは[この記事](https://example.com)を参照。→ paragraph { children: [text, link, text] }(子要素が3つ)。
条件1を満たさないので対象外
- [参考記事](https://example.com)→ list → listItem → paragraph { children: [link] }。
段落の子は1つでlinkだが,親はlistItem。条件1は満たすが条件2を満たさないので対象外
なんとなくどうやって判定すれば良いかわかりますね。実際の判定ロジックは以下の通りです。
function isHttpUrl(url) {
  try {
    const parsed = new URL(url);
    return parsed.protocol === "http:" || parsed.protocol === "https:";
  } catch {
    return false;
  }
}

export function findCardUrl(node, ctx) {
  // 子要素が1つでなければ対象外(条件1の前半:文中インラインリンクなどを除外)
  if (node.children?.length !== 1) return null;

  const child = node.children[0];

  // 唯一の子要素がlinkノードでない,またはhttp/https以外のURLなら対象外
  // (条件1の後半+isHttpUrlガード:「mailto:」等のカード化を防ぐ)
  if (child.type !== "link" || !isHttpUrl(child.url)) return null;

  // 段落の親がroot(本文直下)でなければ対象外
  // (条件2:箇条書き・脚注定義などネストした段落を除外)
  if (ctx.parent(node)?.type !== "root") return null;

  return child.url;
}条件1・条件2に加えて,isHttpUrlによるガードが入っています。段落の子要素がリンク1つだけでも,そのURLがmailto:や#tocのようなページ内アンカーだと,OGPメタデータの取得しようがない壊れたカードになってしまうため,http/https以外のURLは最初から対象外にしています。
ちなみにfindCardUrlをparagraphビジターの中に埋め込まず独立した関数として切り出しているのは,別スクリプトからも判定ロジック単体で参照したいという個別の事情のためです。
キャッシュ参照・新規取得
さて,判定が通ったらensureCardMeta()でキャッシュを確認し,キャッシュに無ければ新たにfetchを行います。
let cache = null;

function getCache() {
  if (cache === null) {
    try {
      cache = JSON.parse(readFileSync(CACHE_PATH, "utf-8"));
    } catch {
      cache = {};
    }
  }
  return cache;
}

function flushCache() {
  writeFileSync(CACHE_PATH, JSON.stringify(cache, null, 2) + "\n");
}

// 同じURLへの重複fetchを防ぐため,取得中のPromiseを共有する
const pendingFetches = new Map();

async function ensureCardMeta(url) {
  const cache = getCache();
  if (cache[url]) return; // キャッシュ済みなら何もしない

  let promise = pendingFetches.get(url);
  if (!promise) {
    promise = fetchMeta(url) // HTMLをfetchしてog:title等を抽出する関数(詳細は割愛)
      .then((meta) => {
        cache[url] = meta;
        flushCache();
      })
      .catch((err) => {
        console.warn(`fetch failed, rendering fallback: ${url} — ${err.message}`);
      })
      .finally(() => pendingFetches.delete(url));
    pendingFetches.set(url, promise);
  }
  await promise;
}(fetchMetaの中身については,後述するog,open-graph-scraperやmetascraperのような既存のOGP抽出ライブラリと基本的に同じであるため解説は割愛します)
キャッシュ構造
ここでcacheに格納・永続化される中身,つまりlink-cards.jsonの実際の構造を示しておきます。URLをキーにしたフラットなオブジェクトで,値はfetchMetaが返す{ title, description, image }です。実際のキャッシュファイルから1件抜粋すると,次のようになっています。
{
  "https://astro.build/blog/astro-7/": {
    "title": "Astro 7.0 | Astro",
    "description": "Astro 7.0 brings faster builds with Vite 8, a new Rust compiler, Advanced Routing, background dev server support, and structured logging.",
    "image": "https://astro.build/_astro/og-astro-7.BAGlEZn4.jpg"
  }
}title・description・imageはいずれも,取得先のページに対応するOGPタグ(titleは<title>タグへのフォールバック込み)が無ければnullになります。後述のrenderCardHtml側でmeta?.titleのようにoptional chainingで受けているのはこのためです。
重複防止の仕組み
pendingFetchesは,同じURLへの重複fetch防止です。具体的には,
- 同じページ内で複数のvisitorが並行実行される
- 記事をまたいで,Astroのcontent layerが複数の記事ファイル自体を並行に同期する(
glob()ローダーのソースコードを確認したところ,Promise.allと同時実行数の制限で複数ファイルを処理していました)
場合を想定しています。
Mapから取り出す処理と書き込む処理の間にawaitを挟まない一続きの同期処理にすることで,複数のvisitorがほぼ同時にこの判定に来ても,2回目以降は1回目が返すPromiseを待つだけになります。
カードのHTML生成
最後にカードのHTMLを組み立てて段落を置換します。
export function domainOf(url) {
  try {
    return new URL(url).hostname.replace(/^www\./, "");
  } catch {
    return url;
  }
}

// 自サイト(SITE_ORIGIN)へのカードは同タブ遷移のままにしたいので,
// target/rel属性はオリジンが自サイトと異なる場合だけ付与する。
function isExternalUrl(url) {
  try {
    return new URL(url).origin !== SITE_ORIGIN;
  } catch {
    return false;
  }
}

export function renderCardHtml(url, cache, fallbackText = "") {
  // ensureCardMetaが書き込んだ{ title, description, image }をキャッシュから取り出す
  // fetch失敗時はundefined
  const meta = cache[url];

  // OGPが取れなくても常に出せるようurlから直接計算する
  const domain = domainOf(url);
  const favicon = `https://www.google.com/s2/favicons?sz=64&domain=${encodeURIComponent(domain)}`;

  // metaがundefinedだったりOGPタグが無い場合はフォールバック
  // meta(OGP)・fallbackText(リンクの表示テキスト)の順に採用し,
  // どちらも無ければドメイン名にフォールバックする
  const title = meta?.title || fallbackText || domain;
  const description = meta?.description || "";
  // imageは画像URLが相対パスだったりした場合に備えてisHttpUrl判定を追加
  const image = meta?.image && isHttpUrl(meta.image) ? meta.image : null;
  const linkAttrs = isExternalUrl(url) ? ` target="_blank"` : "";

  // 外側のdivはTailwindのprose用CSSの打ち消し・余白調整のためのスタイリング目的
  return `<div class="not-prose my-1"><a href="${escapeHtml(url)}"${linkAttrs} class="card sm:card-side bg-base-200 hover:shadow-lg transition-shadow overflow-hidden no-underline">${
    image
      ? `<figure class="sm:w-40 shrink-0 bg-base-300"><img src="${escapeHtml(image)}" alt="" class="w-full h-full object-cover" loading="lazy" /></figure>`
      : ""
  }<div class="card-body p-4 gap-1"><p class="card-title text-base m-0">${escapeHtml(title)}</p>${
    description
      ? `<p class="text-sm text-base-content/70 line-clamp-2 max-h-10 m-0">${escapeHtml(description)}</p>`
      : ""
  }<p class="text-xs text-base-content/50 flex items-center gap-1 m-0 mt-1"><img src="${escapeHtml(favicon)}" alt="" width="14" height="14" class="inline-block rounded-sm" />${escapeHtml(domain)}</p></div></a></div>`;
}
表示するタイトルの決め方
カードのtitleは,「OGPのtitle → リンクの表示テキスト → ドメイン名」という優先順位で決めています。OGPの取得はfetchMetaがネットワーク越しに行う以上,サイト側の一時的な障害やレート制限で失敗することがあります。とはいえ,外部リンクを書く時は基本的にURLベタ貼りではなく
[Google Favicon API Documentation - Logo.dev](https://www.logo.dev/docs/google-favicon-api)のようにタイトルを付けるようにしているので,OGP取得に失敗した場合の次善の情報源としてこれを使い,ドメイン名だけの表示は両方とも無い場合の最後の手段として一応置いています。
linkノードの表示テキストを取り出すヘルパー関数では,children配下に強調などの文字装飾が挟まっている場合もあるため,再帰的にtextノードを辿って連結しています。取り出したテキストがlinkNode.url自体と同じ場合(=著者が意味のある表示テキストを与えていないベタ書きリンク)は,titleとして採用する価値が無いため空文字を返し,ドメイン名へのフォールバックに委ねます。
function linkNodeText(linkNode) {
  const parts = [];
  const walk = (n) => {
    if (n.type === "text") parts.push(n.value);
    else n.children?.forEach(walk);
  };
  linkNode.children.forEach(walk);
  const text = parts.join("").replace(/\s+/g, " ").trim();
  return text !== linkNode.url ? text : "";
}
favicon取得方法
faviconの取得は,Googleの非公式エンドポイントに投げています。愚直にやろうとすると<link rel="icon">や/favicon.icoなど置き場所・形式がサイトごとにバラバラなfaviconの検出・PNG変換・見つからない場合のフォールバック画像出しを全部自前で実装する羽目になるので。非公式ゆえ,突然提供が終了するリスクは引き受ける必要がありますが。
最後のreturnで,ここまでに用意した値を埋め込んでカード全体のHTML文字列を組み立てます。imageとdescriptionはそれぞれ三項演算子で「値があればその要素のHTMLを埋め込み,無ければ空文字」という分岐になっており,画像や説明文が無いOGPでもレイアウトが崩れないようにしています。また,値を埋め込む箇所はすべてescapeHtml()を通しています。title・descriptionはOGPタグとして外部サイトが自由に設定できる値なので,エスケープを怠るとXSSの入口になります。
HTML要素: アンカー
<a>については,「内部リンクは同タブ,外部リンクは新規タブ」という設計にしているため,isExternalUrlでSITE_ORIGINをチェックをし,外部サイトの場合だけtarget="_blank"を付与するようにしています。
target="_blank"について調べると,「target="_blank"をセットする場合はrel="noopener"を付けるのがマスト」みたいな記事がよくヒットしますが,ここでは特に指定していません。
noopenerとは,新規で開いた閲覧コンテキスト(ここでは新規タブ)でWindow.openerをnullにする,つまりリンク元の閲覧コンテキストで開くURLを書き換えられないようにするための設定です。以前はtarget="_blank"をセットする場合はnoopenerを付けるのがマストで,これがないと悪意あるサイトのリンクをうっかり新規タブで開いてしまった時に,元のタブでフィッシングサイトなどが開かれてしまうリスク(アダルトサイトとかで見る)がありましたが,現在はrel=openerを付けない限りWindow.opener=nullになるのがデフォルトになっているので,わざわざ古いバージョンのブラウザを使っている閲覧者のことまで考慮する必要もないかなと思い,relなしという選択をしました。
HTML要素: Tailwind関連
全部説明しているとキリがないので,調整が必要だったところだけ説明する形にさせていただきます。
- 外側の
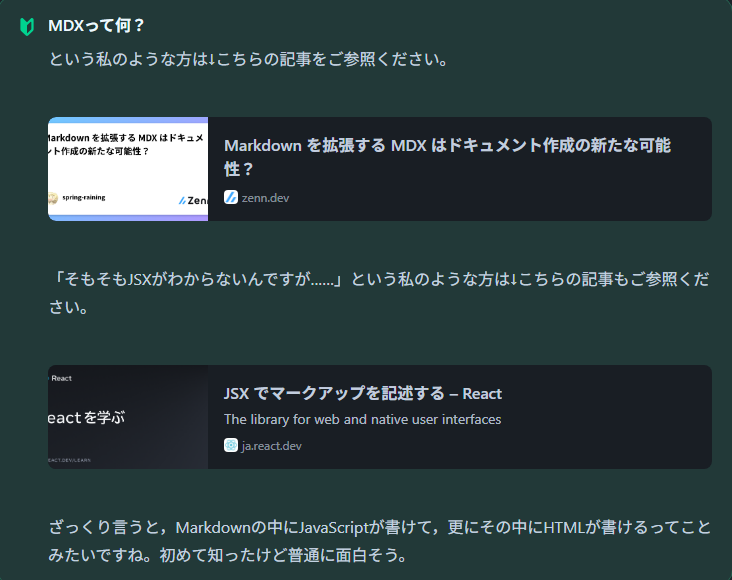
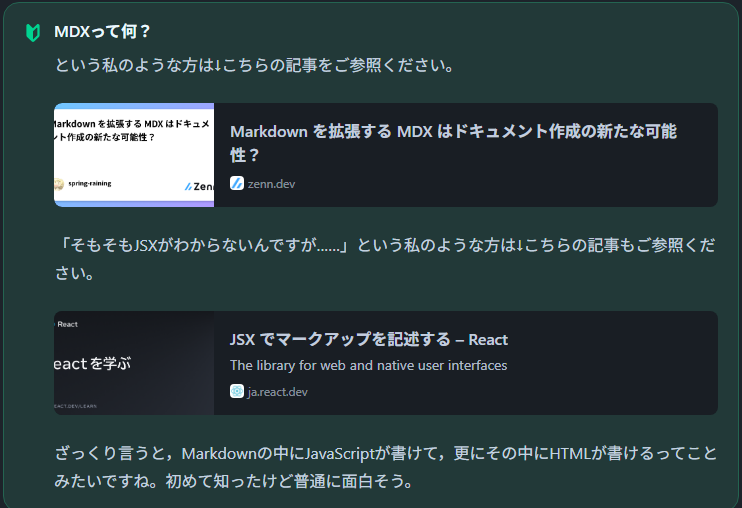
<div>の余白はmy-1にしています。最初はmy-6にしてたんですが,前の段落との距離が遠いと関連性が薄れてしまう感じがしたので詰めました。
- サイト説明文の
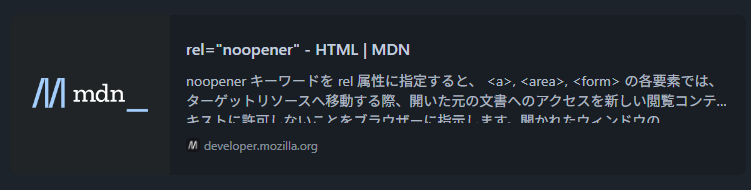
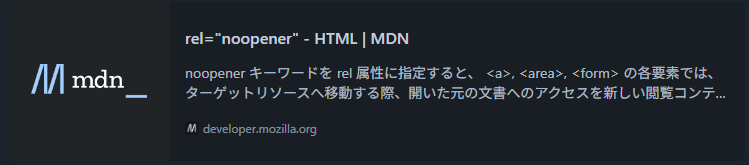
<p>要素は,2行目以降を省略するためline-clamp-2を付けているんですが,CSS Grid内でこの<p>の高さが変わることによって省略されるはずの3行目が見切れてしまう問題が発生したため,max-h-10を付けて<p>の高さを固定することで解決しました。
プラグイン定義
以上をまとめて,プラグインの定義は以下のようになっています。
export const linkCardPlugin = defineMdastPlugin({
  name: "link-card",
  async paragraph(node, ctx) {
    const url = findCardUrl(node, ctx);
    if (!url) return;

    // findCardUrlがnull以外を返した時点でchildren[0]がlinkノードであることは保証済み
    const fallbackText = linkNodeText(node.children[0]);

    await ensureCardMeta(url);
    ctx.replaceNode(node, {
      type: "html",
      value: renderCardHtml(url, getCache(), fallbackText),
    });
  },
});ctx.replaceNodeの第二引数に渡せる置換先には,{ rawHtml: string }(Markdown/HTML文字列として与え,Sätteri内部のRust側パーサーで再パースされる)と{ type: "html", value: string }(mdastのHtmlリテラルノードとしてツリーにそのまま挿入され,再パースを経ない)の2種類があり,ここではrawHtmlではなく{ type: "html", value }を使っています。
段落まるごと置換する今回のようなブロック位置では,実は両者の出力に違いはありません。差が出るのは,文中の一部だけを置換するインライン位置で,そちらではrawHtmlが<p>が二重に入れ子になった不正なHTMLを出力してしまうケースがあります。今回のカードは常にブロック位置での置換なので実害はありませんでしたが,挙動として安全な{ type: "html", value }を採用しました。両者の挙動差の検証結果は別記事にまとめる予定です。
astro.config.mjsへの登録
「全体設計」の③で触れた登録部分の実際のコードがこちらです。
// astro.config.mjs
import { defineConfig } from "astro/config";
import { satteri } from "@astrojs/markdown-satteri";
import { linkCardPlugin } from "./src/lib/link-cards.mjs";

export default defineConfig({
  markdown: {
    processor: satteri({
      mdastPlugins: [linkCardPlugin],
    }),
  },
});mdastPluginはmdastPlugins配列に,hastPluginはhastPlugins配列に渡します。「プラグインの種類」節で見た2種類の区別は,ここでも登録先の配列という形でそのまま現れます。
実装で躓いたポイント
og:imageがCross-Origin-Resource-Policyでブラウザ側から読み込めない
ある外部サイトのog,サムネイルが壊れたアイコンとして表示される事象が発生しました。
原因は,そのサイトの画像レスポンスにCross-Origin-Resource-Policy: same-originヘッダーが付いていたことです。ブラウザは別オリジンの<img>からこのヘッダーが付いた画像を読み込むことを拒否するため,別オリジンであるこのブログに埋め込むと画像だけが読み込めずに壊れます。
厄介なのは,Node.jsのfetch()(やcurl)はCORPを一切評価しないという点です。事前のOGP取得時点ではHTTP 200で正常に取得できてしまうため,このチェックが無いとビルドは何のエラーも出さず,実際にブラウザでページを開いて初めて気付くことになります。
対処として,og(405が返る場合はGETにフォールバック),レスポンスのCross-Origin-Resource-Policyヘッダーがsame-originまたはsame-siteなら,画像を採用せずドメイン名のみのフォールバック表示に倒すようにしています。実装は以下の通りです。
async function isImageEmbeddable(imageUrl) {
  // 自サイトのOGPの場合は即座にtrueを返す
  if (new URL(imageUrl).origin === SITE_ORIGIN) return true;

  let res = await fetch(imageUrl, { method: "HEAD" });
  if (!res.ok && res.status !== 405) return true;
  if (res.status === 405) {
    res = await fetch(imageUrl); // HEAD非対応サイト向けのフォールバック
  }
  const corp = (res.headers.get("cross-origin-resource-policy") || "").toLowerCase();
  return corp !== "same-origin" && corp !== "same-site";
}
まとめ
Sätteriのプラグインの作り方がなんとなくわかったかと思います。簡単そうに見えて奥が深いですね。読んでいただいた方の参考になれば幸いです。それでは。
参考
Open Graph protocolの略。Webページに「SNSで共有されたときにどう見せたいか」のメタ情報を持たせるための規格。
<head>の中にog:title(タイトル)・og:description(説明)・og:image(サムネイル画像)といった<meta>タグを書いておくと,SNSやチャットにURLを貼ったときにそれらが読み取られてカード状に表示される。